
NVIDIA 发布 Jetson Thor 新品:T3000 与 T2000 模组,重新定义主流机器人与边缘 AI 算力
一、物理 AI 浪潮催生主流算力需求,Jetson Thor 矩阵补齐关键一环
通用机器人与自主机器正从研究实验室迈向现实世界,进入规模化商业部署阶段。新一代机器人依靠自然语言交互、物理环境感知、轨迹预测、自主推理完成复杂作业,人形机器人、工业机械臂、自主移动机器人、无人机、智能交通设备均在此浪潮中快速落地。然而,边缘部署面临难以绕开的硬性约束——机器人有效载荷、电池容量、散热空间有限,内存资源短缺成为制约大模型、多模型并发运行的核心痛点。
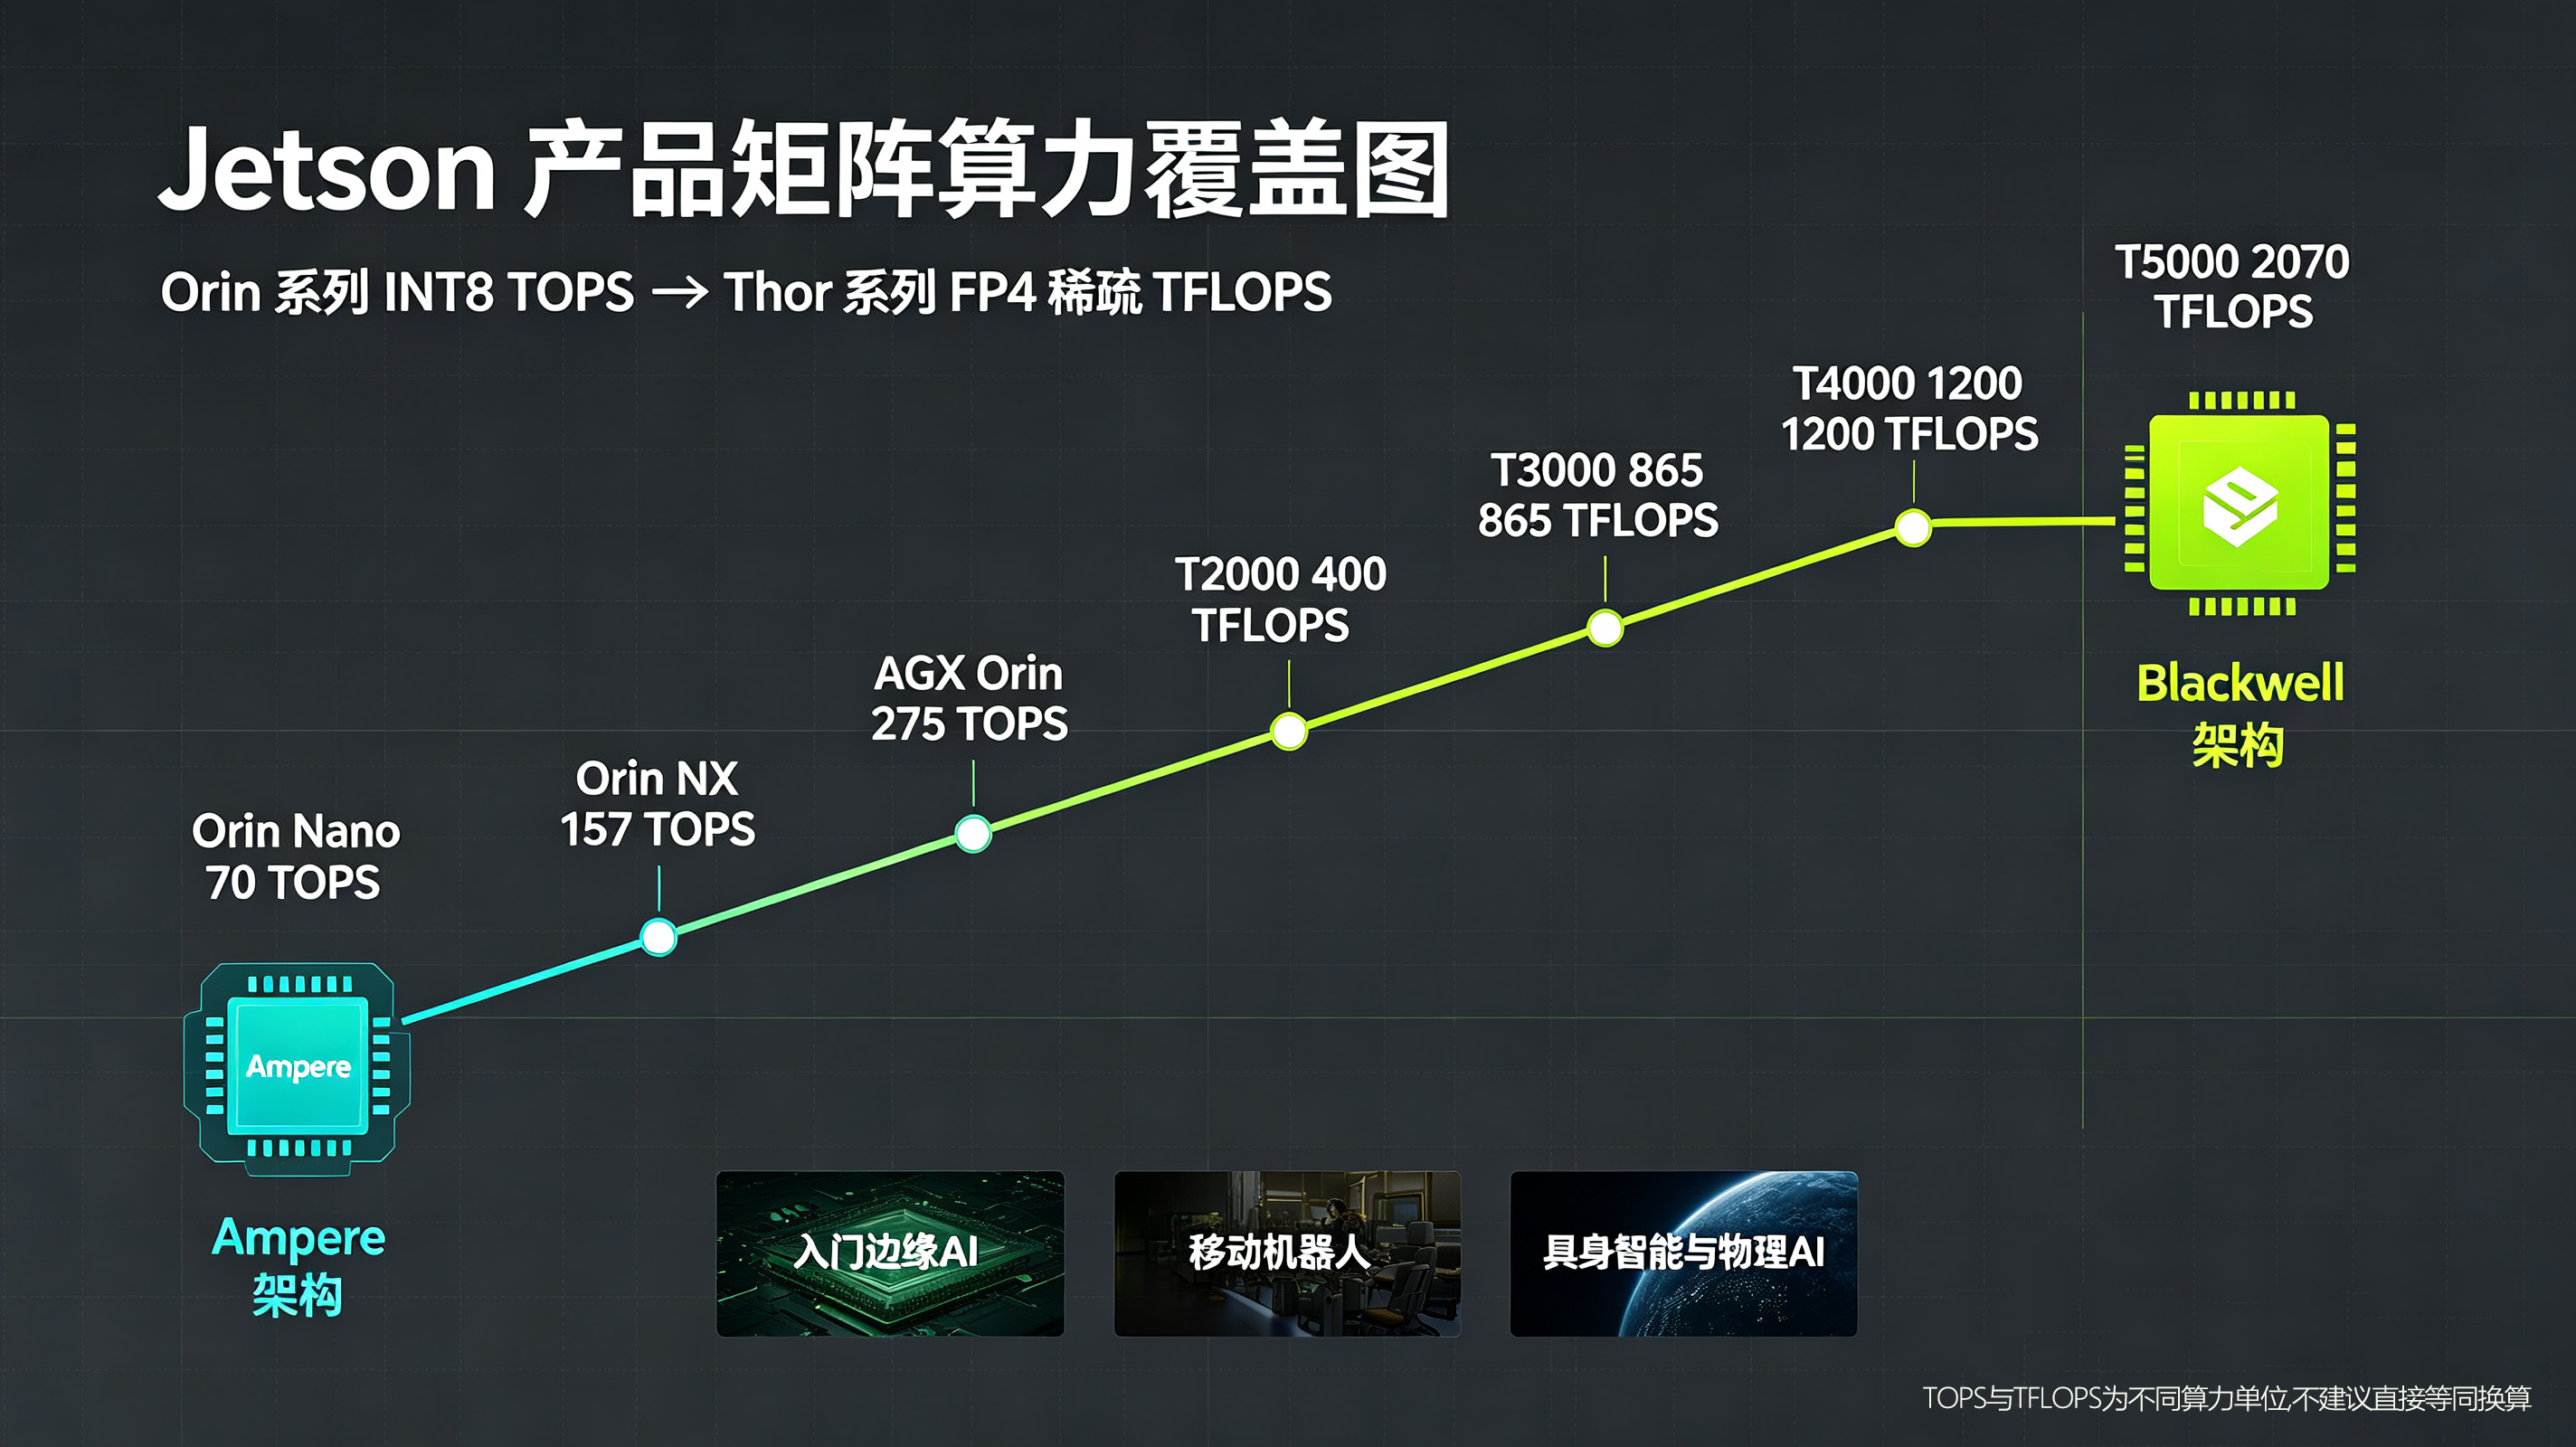
在此背景下,NVIDIA 正式推出 T3000 与 T2000 两款全新模组。两款新品均搭载旗舰级 Blackwell GPU 核心,采用与 Orin Nano 一致的信用卡级小巧外形,补齐 Jetson 产品矩阵中"中端主流"算力空白,实现从入门级(70 TOPS)到旗舰级(2000+ FP4 TFLOPS)的完整可扩展平台覆盖。目前,1X、Agile Robots、Amazon Robotics、波士顿动力、FANUC、日立及达明机器人等行业领先企业已基于 Jetson AGX Thor 平台进行开发。
二、T3000:体积功耗减半,推理性能直追旗舰 T5000
Jetson T3000 定位为人形机器人与高端机器人部署的主力算力单元。该模组在紧凑外形下可提供 865 FP4 TFLOPS 的 AI 算力,尺寸与功耗仅为旗舰 T5000 的一半。硬件方面,T3000 集成 NVIDIA Blackwell GPU(1536 个 CUDA Core)、八核 Neoverse Arm CPU、32GB LPDDR5X 内存及 273GB/s 内存带宽,并支持 25 GbE 网络连接,满足多激光雷达、多路视觉相机同步高速数据传输需求。
尽管体积更小,T3000 在大语言模型(LLM)、视觉语言模型(VLM)、视觉语言动作模型(VLA)及世界基础模型等多模态负载上的推理性能仍与 T5000 相当。在当前内存价格居高不下的背景下,迁移至 T3000 可有效降低整机 BOM 成本。同步推出的 IGX T3000 工业安全版本,集成功能安全机制,可无缝运行 NVIDIA Halos for Robotics 全栈安全系统,确保机器人在人机协作场景中的安全运行,满足 ISO 26262、IEC 61508 等工业安全标准。
三、T2000:Blackwell 架构下沉,边缘 AI 规模化普及的入门级选择
Jetson T2000 将 Thor 架构引入更广泛的边缘 AI 系统。凭借 400 FP4 TFLOPS 的算力与 16GB 内存,该模组为开发者构建视觉 AI 智能体、自主移动机器人、工业机械臂及其他智能设备提供了入门级选择。硬件方面,T2000 搭载 1024 个 Blackwell GPU Core、6 核 Arm CPU,标准功耗仅 40W,外形尺寸完全兼容 Orin Nano 载板,算力达到 Orin Nano 的 5-6 倍。
T2000 特别适合小型自主移动机器人、仓储 AGV、单目视觉检测设备、小型巡检无人机、零售智能识别终端及轻量化教育人形机器人等场景。40W 低功耗适配电池供电设备,在算力与续航之间实现平衡。开发者可在项目初期使用 Orin Nano 开发套件验证算法,当多模型并发或大 VLM 推理出现内存压力时,无缝升级至 T2000,无需重新设计载板。
四、T3000 与 T2000 核心规格对比
| 规格项 | Jetson T3000 | Jetson T2000 | Jetson AGX Orin(参考) |
|---|---|---|---|
| AI 算力(FP4 稀疏) | 865 TFLOPS | 400 TFLOPS | 275 TOPS(INT8) |
| GPU 架构 | Blackwell(1536 CUDA Core) | Blackwell(1024 CUDA Core) | Ampere(2048 CUDA Core) |
| CPU | 8 核 Arm Neoverse | 6 核 Arm | 12 核 Arm Cortex |
| 内存 | 32GB LPDDR5X | 16GB LPDDR5X | 64GB LPDDR5 |
| 内存带宽 | 273 GB/s | 204 GB/s | 204.8 GB/s |
| 网络 | 25 GbE | 10 GbE | 10 GbE |
| 功耗 | 70W | 40W | 15-60W |
| 外形尺寸 | Orin Nano 级(信用卡大小) | Orin Nano 级(信用卡大小) | 较大尺寸 |
| 功能安全 | IGX 版本支持(Halos) | 不支持 | 不支持 |
| 预计量产时间 | 2027 年 Q1 | 2027 年 Q1 | 已量产 |
五、Jetson Agent Skills:AI 智能体数天完成内存优化,数周变数天
硬件算力释放的同时,NVIDIA 同步推出 Jetson Agent Skills 智能体技能,将代码助手(Claude、Cursor、CodeX 等)转化为专业 Jetson 开发工具,自动化完成内存审计、推理调优、系统裁剪、应用部署。开发者可在数天内完成整个软件栈的优化并有效节省内存,而此前这一过程往往需要数周时间。
该技能支持包括 Jetson Thor 与 Jetson Orin 在内的全系 Jetson 产品组合,使开发者能够在更低内存配置下运行更复杂的工作负载,甚至在同一产品层级内切换至更低内存规格的 SKU而不影响性能。NVIDIA 展示了多个行业客户实践:
人形机器人:优必选、Agile Robots 及 Connect Tech 将内存占用最高降低 15GB,从 Jetson AGX Orin 64GB 迁移至 32GB 版本;
智慧零售:SandStar 将内存占用最高降低 4GB,从 Orin NX 16GB 降至 8GB 模组;
陪伴机器人:GROOVE X(LOVOT 开发商)利用异构 AI 加速器优化工作负载分配,降低内存占用;
智能交通:NoTraffic 在 Jetson TX2 NX 上将内存占用减少 30%,在不增加硬件的前提下拓展更多 AI 功能。
六、Cosmos 3 Edge 登陆 Thor 平台:40 亿参数世界模型端侧运行
NVIDIA 同时扩展了 Cosmos 3 前沿开放世界基础模型系列,新增与 Thor 平台完全兼容的轻量级模型Cosmos 3 Edge。该模型拥有 40 亿参数,能够帮助具身系统感知世界、进行实时推理,并通过端侧推理预测和生成动作。借助开放的 Cosmos 框架,开发者仅需约一天时间,即可针对特定机器人本体与传感器对 Cosmos 3 Edge 进行后训练,有效弥合仿真与现实之间的差距,随后部署于 Jetson Thor 实现实时视觉分析与端侧机器人策略执行。
七、芯铭信息科技:NVIDIA 生态的本地化桥梁,助力 Jetson Thor 全系列落地
作为 NVIDIA 核心合作伙伴,芯铭信息科技始终紧跟 Jetson Thor 产品线节奏,为客户提供从旗舰 T5000 到全新 T3000/T2000 模组的全系列产品选型、开发套件供应及本地化技术支持服务。芯铭信息已具备 Jetson AGX Thor 开发者套件(CTK-5000-A)的供货能力,开发者可通过仿真模式立即开始 T3000/T2000 的软件开发工作。
在硬件交付之外,芯铭信息同时提供载板定制、系统适配、AI 模型部署优化等增值服务,帮助企业客户快速完成从原型验证到批量量产的全流程。结合 NVIDIA Isaac 机器人仿真平台、Isaac GR00T 人形机器人基础模型、Nemotron 开放模型及 Cosmos 3 Edge 等完整软件生态,芯铭信息致力于成为国内机器人与边缘 AI 开发者的首选技术合作伙伴。
开发与供货信息
仿真模式:T3000 仿真模式已于 2026 年 7 月通过 JetPack 7.2.1 开放;T2000 仿真模式将在后续版本中推出。
量产时间:Jetson T3000 与 T2000 模组预计于 2027 年第一季度正式供货。
开发套件:可通过芯铭信息科技或 NVIDIA 渠道合作伙伴获取 Jetson AGX Thor 开发者套件,立即开启开发。
配图
NVIDIA Jetson Thor, T3000, T2000, Blackwell 架构, 边缘 AI, 人形机器人, 物理 AI, Jetson Agent Skills, Cosmos 3 Edge, JetPack 7.2, IGX T3000, Halos for Robotics, 自主移动机器人, 视觉 AI 智能体, 边缘计算模组, 芯铭信息科技, NVIDIA 核心合作伙伴, 机器人算力, 端侧推理, 具身智能